“大模型赋能人文社科工作坊”第六期于2026年10月30日(星期五)13:00—15:00在中国社会科学院大学教学综合楼317机房成功举办。本次工作坊紧密围绕深入实施“人工智能+”行动,聚焦WorkBuddy国内版与国际版的使用及大模型本地部署方法,旨在帮助师生了解人工智能工作台的功能特点与应用场景,掌握本地大模型部署、调用及科研数据处理的基本方法,推动人工智能技术与人文社会科学研究的深度融合。
一、工作坊概况
本次工作坊以“WorkBuddy国内版、国际版使用与大模型本地部署方法”为主题,由中国社会科学院大学计算社会科学研究中心、计算社会科学与国家治理实验室和计算机教研部共同举办,面向全校对人工智能与人文社会科学交叉研究、大模型工具应用感兴趣的师生开放。
活动围绕WorkBuddy不同版本的访问与基本操作、功能特点与适用场景、大模型本地部署的环境准备与基本流程,以及本地模型的调用与科研应用等内容展开。与单纯介绍工具功能不同,本期工作坊更加注重工具应用与具体科研任务的结合,通过数据描述、访谈脱敏、评论编码等案例,介绍如何明确任务目标、准备输入材料、设置输出要求、限定操作范围并核验处理结果,为师生开展计算社会科学研究提供了具体的方法参考。
本次活动吸引了近170名师生报名参与,参与者覆盖本科生、研究生、博士生和教职工等多个群体,学科背景涉及应用经济学、马克思主义理论、经济学、社会学与民族学、政府管理、文学、历史学、新闻传播学、法学、商学、哲学、外国语言文学、全球与区域国别研究等多个方向,体现出大模型技术在人文社科领域的广泛吸引力。
根据现场签到表统计,本次工作坊共有59名师生到场参加(报名175人次,去重后171人,到场率约34.5%)。从身份构成看,本科生24人、硕士研究生12人、博士研究生17人、教职工6人,学生占到场人员的89.8%。
二、主讲内容与上机实操
计算社会科学研究中心主任、计算社会科学与国家治理实验室负责人蒋欣兰担任本次工作坊主讲嘉宾,于13:00—14:20开展专题讲授;计算社会科学研究中心副主任朱俭于14:20—15:00指导师生进行上机实操。两位老师围绕人工智能工作台使用与大模型本地部署,结合人文社科研究的实际需求,介绍工具操作、任务设计与结果核验的方法。
在主题分享中,蒋欣兰首先介绍了WorkBuddy国内版与国际版的访问、安装及基本操作,对不同版本的功能特点与适用场景进行比较,并结合工作空间设置、问答模式和计划模式等功能,说明人工智能工作台在科研任务中的使用方式。
围绕如何让大模型更好地服务科研任务,蒋欣兰提出,研究者不能仅向工具提出笼统需求,而应明确任务目标、输入材料、输出要求、操作约束和结果验收五项内容。结合新闻平台数据描述分析与政策文本整理案例,她展示了如何设定任务范围、保留原始材料、检查缺失数据并核对统计结果,特别提醒师生关注模型在数据处理过程中可能出现的样本删除、数据修改等问题,将结果核验贯穿科研工作流程。
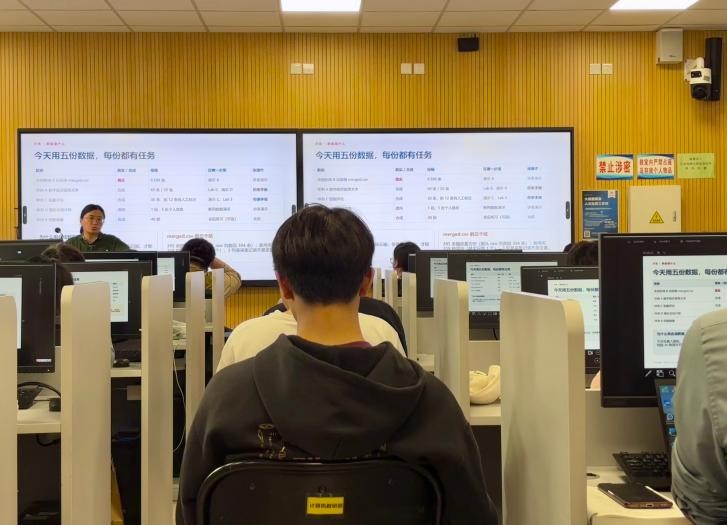
围绕大模型本地部署,蒋欣兰进一步介绍了Ollama的环境准备、模型管理与调用流程,演示如何查看已安装模型、启动模型对话,以及通过本地接口处理研究材料。针对访谈记录、未公开资料等研究数据,她强调应根据数据权限与敏感程度合理选择处理环境,避免将未经脱敏的材料直接上传至云端。通过断网环境下的操作及访谈片段脱敏演示,她介绍了本地模型在研究数据保护方面的应用价值,同时提醒师生关注不同模型的处理能力,认真检查姓名、联系方式等敏感信息是否脱敏完整,并保留模型版本与处理记录,为后续研究复核提供依据。
在文本分析应用方面,蒋欣兰以评论文本编码为例,介绍如何依据既定编码规则对文本进行分类,将人工标注与模型标注结果进行比较,并运用Cohen’s Kappa系数检验标注一致性。结合短剧评论等案例,分享进一步说明了编码规则制定、人工核对与模型辅助标注之间的关系。她特别指出,模型编码效果的检验应注意人工标准答案与模型处理过程的相互独立,不能仅凭较高的一致性数值判断结果可靠,还应结合不一致案例进行具体分析,确保编码结果具有可信度。
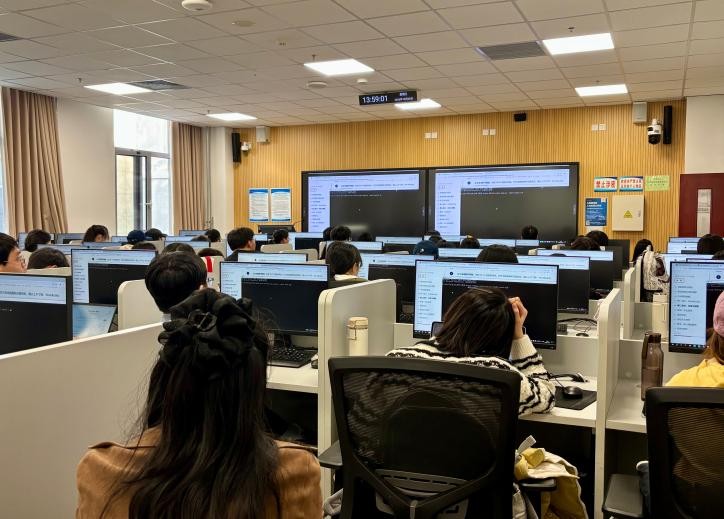
14:00—15:00,朱俭老师指导参与者开展上机实操,围绕资料包准备、工作空间设置、任务输入与本地模型调用等环节进行操作指导。师生结合讲座提供的数据和示例,尝试完成数据整理、访谈脱敏与文本编码等任务,将前一阶段的讲解转化为实际操作。实操过程中,朱俭老师强调应先选取少量样本测试运行效果,再逐步扩大处理范围,并对照原始材料检查模型输出,帮助参与者进一步理解相关工具的使用方法与适用边界。
三、活动亮点
云端工具与本地模型的应用场景拓展:本期工作坊围绕WorkBuddy国内版、国际版及Ollama本地部署展开,介绍不同工具的功能特点与基本操作,帮助师生根据研究任务和数据特点选择适宜的处理方式,拓展人工智能工具在科研中的应用路径。
面向真实科研任务的操作方法讲解:活动将工具使用与新闻平台数据分析、政策文本整理、访谈脱敏和评论编码等具体场景相结合,突出任务设计与工具操作的衔接,帮助师生将大模型能力转化为可实际应用的科研方法。
贯穿数据处理全过程的质量控制:通过缺失数据检查、原始材料核对、人工标注与一致性检验等案例,工作坊强调模型输出不能替代研究者的专业判断,推动师生建立数据核验与结果复查意识。
兼顾技术应用与科研数据安全:活动围绕访谈记录等敏感研究材料,介绍本地部署与脱敏处理的基本方法,强调根据数据权限选择处理环境、保留必要操作记录,促进人工智能技术应用与科研规范相结合。
专题讲授与机房实操相结合:本次工作坊由蒋欣兰开展专题讲解、朱俭指导上机操作,将工具介绍、模型部署与实际科研案例相衔接,形成从原理讲解、操作演示到动手实践的完整学习过程。
四、参与者积极交流
活动现场学习与交流氛围浓厚,参与者围绕软件安装、工作空间选择、模型运行及示例任务操作等问题展开交流,并在机房环境中尝试使用不同工具,将实际操作与讲授案例相互对照。针对模型运行与预期不一致的情况,两位老师结合具体操作进行指导,帮助参与者进一步理解任务要求设置、处理环境选择和输出结果核验等关键环节。
本次工作坊也进一步引导师生思考人工智能辅助科研中的责任分工。一方面,人工智能工作台与本地模型能够承担部分资料整理、文本处理和重复性分析任务,为研究者提高工作效率提供支持;另一方面,数据使用权限、模型输出的可信程度以及研究结论的依据,仍需要研究者进行独立判断。通过访谈脱敏、评论标注与一致性检验等案例,活动强调在发挥大模型辅助作用的同时保留必要的人工参与和结果复核,使技术应用真正服务于规范、可靠的人文社会科学研究。
五、结语
此次工作坊围绕WorkBuddy不同版本的使用与大模型本地部署,系统介绍了人工智能工作台的基本操作、科研任务设计及本地模型调用方法,并通过数据整理、访谈脱敏和文本编码等案例,展示了大模型技术在人文社会科学研究中的具体应用路径。
未来,我们将持续聚焦人工智能在人文社科领域的前沿动态,依托实验室的数据、方法、算力与平台资源,推出更多兼具理论深度和实践价值的学术活动,助力师生拓展研究方法、提升科研能力,共同推动人文社会科学研究的数字化、智能化与高质量发展。
中国社会科学院大学计算社会科学研究中心
中国社会科学院大学计算社会科学与国家治理实验室
中国社会科学院大学计算机教研部
2026年10月30日


 微信